数据拟合处理时要特别注意外推(Extrapolation)的问题,因为外推极易可能导致无意义的数据,然后在实际情况中我们最需要的正是通过外推来进行趋势预测。怎么评价外推数据的合理性问题在不同的应用场景中也有不同的解决办法,假设检验给我们提供了新的思路,这里就以可扩展性算法的并发性能的问题为例来说明。
随着计算机CPU 性能向上扩展(scale up)逐渐遇到瓶颈问题,一场横向扩展(scale out)的竞赛正在加速,硬件的横向发展同时也给软件带来了巨大的可扩展性挑战,特别是操作系统层面上的性能瓶颈问题越来越明显。扩展性的优劣直接决定了大规模云服务器系统的整体效能,对于百万数量级的计算中习而言,哪怕是较小的效能提升都代表着巨大的经济利益。下图为使用objpool新方案替代原来的freelist实现以解决扩展性性能问题的实例。从图中可看出 freelist方案的性能数据并没有随着线程数的增加而快速增加,而objpool方案要远远好于原来的freelist方案。
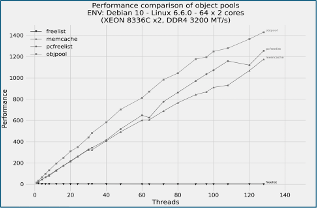
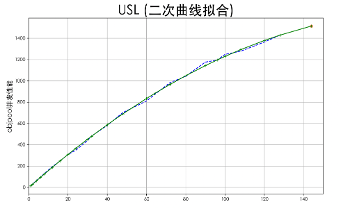
针对此类并行算法的评估一般使用通用可扩展性定律/USL(Universal Scalability Law),由Dr. Neil Gunther在1993 年CMG 会议中所提出,此定律是在阿姆达尔定律(Amdahl‘s Law)的基础之上增加了一个通讯或一致性的损耗因子,本质上是一个一元二次方程的拟合处理。
实测环境的硬件线程的上限为128,我们无法直接测算144线程的实际数据,而未来很可能要扩展到144/256甚至更多线程的系统上,此情况下我们只能通过计算手段进行 预测与评估。下图中橘红色点即为外推预测出的144线程并发的性能数值。一般情况下我们直接使用USL定律的结论,而现在我们可以使用本次课堂上所学到的假设检验手段做进一步的验证。
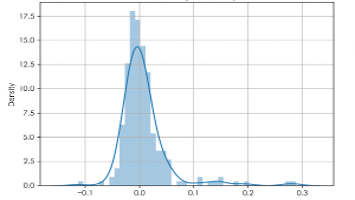
此处将采用逐渐逼近的方式,先根据前6组数据推算出第7组的数据,并计算预测数据与实测数据的差异率,然后逐步向后推进直到最后一组。一般约定差异率在-5%及有关5%之间则为可接受数据,故此假设检验为双侧检验。下图展示出了预测值与实测值的差异率数值的分布,从图中可以看出差异率的数据呈现出正态分布的规律,这也是我们能使用假设检验的基础:
验证方法:
H0: 预测值与实测值差异率超出5%,故不接受外推预测
H1: 预测值与实测值差异率不超出5%,故推翻H0并接受外推预测
| 假设检验计算 | |||
|
平均差异率 |
0.02550639692225448 |
标准差 |
0.0024513878828771635 |
|
T值 |
-9.99172886870832 |
Prob(u > 5%) |
1.0559846975389721e-19 |
结论:推翻原假设H0,接受H1,即外推预测值符合预期,使用USL法则外推一组进行预测的可信度非常高。另外对于很难实测或数据量超少的情况较常用的办法是通过构建模拟系统来推测此系统的发展趋势,而假设检验的办法所达成的量化佐证依然适用于这种模拟预测的方式。